Pelajari apa itu crawling dan indexing, perbedaan keduanya, cara kerja Google menemukan halaman web, serta cara mengoptimalkannya untuk SEO
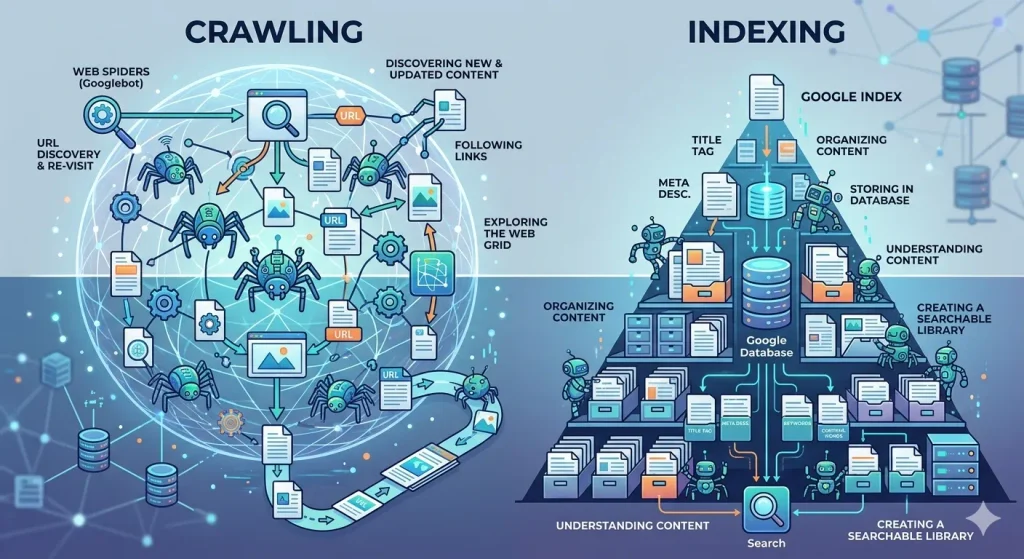
Sebelum sebuah halaman bisa muncul dan menempati peringkat di hasil pencarian (SERP), halaman tersebut harus melalui dua tahapan teknis utama: Crawling dan Indexing. Dalam dunia Search Engine Optimization (SEO), banyak orang justru berfokus pada penulisan kata kunci (keyword) atau pencarian backlink. Padahal, hal tersebut akan sia-sia jika mesin pencari seperti Google tidak tahu bahwa halaman web Anda itu ada.
Memahami crawling dan indexing adalah kunci dasar untuk membuat konten Anda dapat ditemukan dan dinilai oleh Google secara optimal. Dengan memahami kedua konsep tersebut, dan bagaimana cara kerjanya, maka Anda bisa melakukan langkah-langkah yang diperlukan untuk melakukan optimasi pada website Anda.
1. Apa Itu Crawling dan Indexing?
Meskipun sering diucapkan secara bersamaan, crawling dan indexing adalah dua proses teknis yang berbeda namun saling berurutan:
- Crawling (Penelusuran): Proses di mana program otomatis milik mesin pencari (disebut crawler, bot, atau spider—seperti Googlebot) menjelajahi internet untuk menemukan halaman web baru atau halaman yang baru saja diperbarui.
- Indexing (Pengindeksan): Proses menganalisis, memahami, dan menyimpan informasi dari halaman yang telah ditemukan selama proses crawling ke dalam pangkalan data raksasa milik mesin pencari (disebut Google Index).
Analogi Sederhana:
Bayangkan Crawling seperti pustakawan yang pergi mencari dan mengumpulkan buku-buku baru di seluruh dunia, sedangkan Indexing adalah proses membaca, mengkategorikan, dan menyusun buku-buku tersebut ke dalam rak perpustakaan agar pengunjung dapat mencarinya dengan mudah.
2. Alur Kerja: Dari Discovery Hingga Ranking
Secara garis besar, perjalanan sebuah halaman web di mesin pencari melalui 3 tahap utama:
[1. Crawling]  ──>  [2. Indexing]  ──>  [3. Serving / Ranking]
 (Penemuan)          (Penyimpanan)        (Penampilan Hasil)
- Discovery & Crawling: Googlebot menemukan URL baru dengan mengikuti tautan (links) dari halaman yang sudah ada atau melalui peta situs (sitemap.xml).
- Parsing & Indexing: Googlebot mengunduh kode HTML, gambar, dan skrip JavaScript untuk memahami topik konten, struktur halaman, serta konteksnya. Jika konten dinilai layak dan tidak melanggar panduan, halaman disimpankan ke Google Index.
- Ranking (Penyajian Hasil): Ketika pengguna mengetikkan kata kunci pencarian, algoritma Google mengambil halaman-halaman yang paling relevan dari Google Index lalu menampilkan dan mengurutkannya di layar pengguna.
3. Faktor yang Mempengaruhi Proses Crawling & Indexing
Tidak semua halaman web yang dirayapi otomatis akan langsung diindeks. Beberapa faktor teknis berikut mempengaruhi kelancaran prosesnya:
A. Crawl Budget (Anggaran Perayapan)
Mesin pencari memiliki keterbatasan waktu dan sumber daya untuk merayapi setiap situs web. Crawl budget adalah jumlah halaman yang dapat dan ingin dirayapi oleh Googlebot pada sebuah situs dalam kurun waktu tertentu.
B. File robots.txt
Berkas konfigurasi teks yang memberi tahu bot mesin pencari halaman mana yang boleh atau tidak boleh dirayapi. Jika Anda salah memasukkan instruksi di robots.txt, halaman penting bisa tertutup dari proses crawling.
C. Sitemap XML
Dokumen yang berisi daftar seluruh URL penting di website Anda. Sitemap berfungsi sebagai peta panduan bagi Googlebot agar dapat menemukan halaman baru secara lebih cepat.
D. Tag Canonical (rel="canonical")
Tag canonical adalah Atribut HTML yang membantu Google menentukan halaman mana yang menjadi versi utama jika terdapat beberapa halaman dengan konten yang sangat mirip atau identik (duplicate content).
E. Tag Noindex (<meta name="robots" content="noindex">)
Instruksi khusus yang memberi tahu Googlebot untuk tidak menyimpankan halaman tersebut ke dalam basis data Google Index, meskipun halaman tersebut sempat dirayapi.
4. Cara Memastikan dan Mempercepat Indexing di Google
Jika artikel atau halaman baru Anda tidak kunjung muncul di Google, terapkan langkah-langkah optimasi teknis berikut:
- Gunakan Fitur URL Inspection di Google Search Console (GSC):
Masukkan URL artikel Anda pada kolom pencarian di GSC, lalu klik tombol Request Indexing untuk meminta Googlebot merayapi halaman tersebut secara langsung. - Kirimkan Sitemap XML yang Terbarukan:
Pastikan sitemap website Anda sudah terdaftar di menu Sitemaps pada Google Search Console dan diperbarui secara otomatis setiap kali ada artikel baru. - Bangun Struktur Internal Link yang Kuat:
Sisipkan tautan (internal link) dari artikel populer/halaman utama yang sudah terindeks menuju ke artikel baru Anda. Tautan internal adalah jalur utama yang dilalui Googlebot untuk menemukan halaman baru. - Hindari Konten Duplikat dan Kualitas Rendah:
Google cenderung menolak mengindeks halaman yang dinilai tipis (thin content), hasil salinan dari situs lain, atau tidak memberikan nilai tambah bagi pengguna. - Pastikan Kecepatan Server & Responsif:
Server hosting yang sering mengalami kendala (Server Error 5xx) atau sangat lambat dapat membuat Googlebot mengurangi intensitas crawling pada situs Anda.
Kesimpulan
Crawling dan Indexing adalah dua pintu gerbang utama yang menentukan apakah karya dan konten Anda dapat ditemukan oleh jutaan pengguna di internet. Dengan menjaga arsitektur situs tetap rapi, mendaftarkan sitemap.xml di Google Search Console, serta memastikan tidak ada hambatan pada instruksi robots.txt, Anda memberikan akses karpet merah bagi Googlebot untuk mengindeks halaman web Anda secara efisien.
Frequently Asked Questions (FAQ)
Berapa lama waktu yang dibutuhkan Google untuk merayapi dan mengindeks halaman baru?
Waktu yang dibutuhkan bervariasi—mulai dari beberapa menit hingga beberapa hari atau minggu, tergantung pada reputasi otoritas situs, frekuensi pembaruan konten, serta kejelasan struktur navigasi internal link Anda.
Mengapa halaman saya sudah dirayapi (crawled) tetapi belum terindeks (not indexed)?
Di Google Search Console, status “Crawled – currently not indexed” biasanya berarti Google sudah menemukan dan membaca halaman Anda, tetapi memutuskan untuk belum menyimpannya ke indeks. Penyebab umumnya adalah kualitas konten yang dinilai kurang unik, adanya indikasi konten duplikat, atau struktur teknis halaman yang perlu diperbaiki.
Apakah semua halaman di website harus diindeks oleh Google?
Tidak. Halaman-halaman teknis internal seperti halaman admin (/wp-admin/), halaman keranjang belanja (cart), halaman kebijakan privasi, atau halaman pencarian internal sebaiknya tidak diindeks (noindex) agar tidak membuang-buang crawl budget situs Anda.