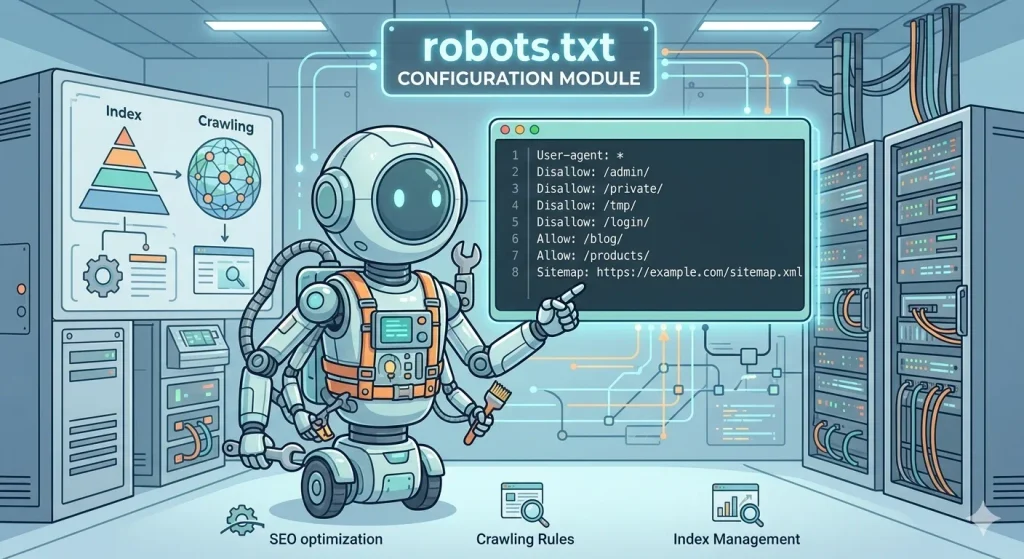
Pelajari apa itu file robots.txt, fungsi pentingnya untuk kontrol crawl budget, serta panduan pengaturannya
Dalam mengelola sebuah website, tidak semua halaman atau direktori ditujukan untuk dikonsumsi secara publik oleh pengguna maupun mesin pencari. Halaman seperti dasbor admin, direktori skrip internal, atau halaman pencarian situs sebaiknya tidak perlu dirayapi oleh bot crawler seperti Googlebot.
Untuk memberi tahu robot mesin pencari bagian mana dari situs yang boleh dan tidak boleh diakses, Anda memerlukan sebuah berkas teks sederhana yang disebut Robots.txt.
1. Apa Itu Robots.txt?
Robots.txt adalah file teks sederhana berformat .txt yang ditempatkan di direktori utama (root directory) sebuah website. Berkas ini berfungsi sebagai panduan instruksi untuk web robot (seperti Googlebot, Bingbot, atau crawler AI) mengenai halaman atau direktori mana saja yang diizinkan (allow) atau dilarang (disallow) untuk dirayapi (crawl).
Robots.txt merupakan bagian dari Robots Exclusion Protocol (REP), yaitu standar komunikasi formal antara pemilik website dan bot crawler.
2. Mengapa Robots.txt Sangat Penting untuk SEO?
Meskipun ukurannya sangat kecil, berkas robots.txt memegang peranan krusial dalam arsitektur teknis dan kinerja SEO website Anda:
- Menghemat Crawl Budget: Mesin pencari memiliki batasan sumber daya (crawl budget) saat merayapi sebuah situs. Dengan memblokir halaman yang tidak penting, Anda memastikan Googlebot berfokus merayapi konten utama yang berharga.
- Mencegah Indeksasi Berkas atau Halaman Internal: Mencegah perayapan pada file sensitif, berkas media internal, atau halaman dasbor admin (
/admin/atau/wp-admin/). - Mengurangi Beban Server: Mencegah bot crawler otomatis merayapi ratusan halaman pencarian internal atau berkas dinamis yang dapat membebaskan sumber daya server.
- Menunjukkan Lokasi XML Sitemap: Memudahkan robot menemukan peta situs (sitemap) utama untuk membantu proses pengindeksan halaman baru secara lebih cepat.
3. Komponen dan Sintaks Dasar Robots.txt
File robots.txt disusun menggunakan kombinasi direktif (perintah) sederhana. Berikut adalah beberapa perintah utama yang sering digunakan:
A. User-agent
Menentukan robot mesin pencari mana yang diberi instruksi.
User-agent: *(Berlaku untuk semua jenis bot/crawler).User-agent: Googlebot(Berlaku khusus untuk perayap Google).
B. Disallow
Melarang robot merayapi URL atau direktori tertentu.
Disallow: /admin/(Melarang akses ke folder admin).
C. Allow
Mengizinkan akses ke sub-folder tertentu di dalam direktori yang sebelumnya dilarang (Disallow).
Allow: /admin/public-info/
D. Sitemap
Menunjukkan lokasi pasti dari berkas XML Sitemap situs Anda.
Sitemap: [https://www.example.com/sitemap.xml](https://www.example.com/sitemap.xml)
4. Contoh Konfigurasi File Robots.txt
Berikut adalah beberapa contoh penerapan berkas robots.txt yang sering digunakan:
Contoh 1: Mengizinkan Semua Bot Merayapi Seluruh Situs (Standar)
User-agent: *
Allow: /

Sitemap: https://www.example.com/sitemap.xml
Contoh 2: Memblokir Direktori Admin dan Halaman Pencarian
User-agent: *
Disallow: /wp-admin/
Disallow: /search/
Disallow: /cart/

Sitemap: https://www.example.com/sitemap.xml
Contoh 3: Memblokir Bot Spesifik (Misalnya AI Crawler)
User-agent: GPTBot
Disallow: /
5. Kesalahan Umum yang Harus Dihindari
Membuat kesalahan kecil pada berkas robots.txt dapat berdampak fatal bagi kesehatan SEO situs Anda. Perhatikan hal-hal berikut:
- Jangan Gunakan
Disallow: /Secara Tidak Sengaja: Perintah ini melarang perayapan pada seluruh isi website. Jika tidak sengaja terpasang, website Anda dapat hilang dari halaman hasil pencarian Google (SERP). - Robots.txt Bukan Cara untuk Menyembunyikan Data Sensitif: File robots.txt bersifat publik dan dapat diakses oleh siapa saja dengan mengetikkan
[domain.com/robots.txt](https://domain.com/robots.txt). Gunakan otentikasi kata sandi (password protection) atau tagnoindexuntuk data yang benar-benar rahasia. - Format Penulisan Harfiah (Case-Sensitive): Jalur direktori membedakan huruf besar dan kecil.
Disallow: /Admin/tidak akan memblokir folder/admin/.
Kesimpulan
Robots.txt adalah pintu gerbang utama yang mengatur bagaimana robot mesin pencari berinteraksi dengan website Anda. Dengan mengonfigurasi perintah perayapan secara akurat, Anda dapat mengoptimalkan penggunaan crawl budget, melindungi area internal situs, dan memastikan Googlebot memprioritaskan halaman-halaman terbaik Anda.
Frequently Asked Questions (FAQ)
Di mana lokasi penyimpanan file robots.txt yang benar?
File robots.txt harus disimpan di direktori akar (root directory) website Anda, sehingga dapat diakses langsung melalui URL utama: [https://www.example.com/robots.txt](https://www.example.com/robots.txt).
Apakah memblokir halaman di robots.txt otomatis menghapusnya dari Google?
Tidak selalu. Jika halaman tersebut dilarang dirayapi di robots.txt, tetapi masih memiliki backlink atau tautan internal dari situs lain, Google mungkin tetap mengindeks URL tersebut tanpa membaca isinya. Untuk benar-benar mencegah indeksasi, gunakan meta tag noindex pada halaman terkait.
Bagaimana cara menguji apakah file robots.txt saya sudah benar?
Anda dapat menggunakan alat uji gratis seperti Robots.txt Tester di Google Search Console atau memeriksa laporan Crawl Stats untuk memastikan Googlebot tidak mengalami kendala perayapan.
Berapa lama waktu yang dibutuhkan Google untuk membaca perubahan di robots.txt?
Googlebot biasanya memperbarui salinan cache file robots.txt situs Anda setiap beberapa jam hingga sekali sehari. Jika Anda memperbarui filenya, perubahan instruksi akan berdampak pada sesi perayapan berikutnya.